VOCABULARY / 词条
AI 垃圾内容
AI Slop
用生成模型批量产出、几乎不投入编辑与核实的内容:它的目的是占据信息流与搜索结果的位置,而不是对读者有用;单看一篇未必有明显错误,但成批出现时会把有价值的内容挤出可见范围。
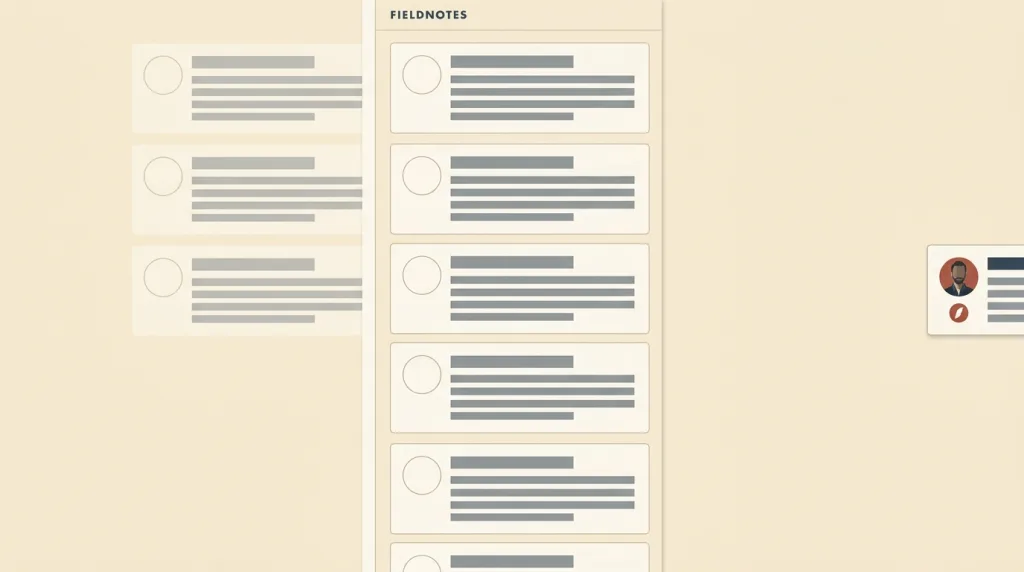
识别特征
- 同一模板的大量页面或帖子在短时间内出现
- 内容回答的是检索词而不是读者的问题,正文绕开具体结论
- 没有署名、没有来源,也没有人对准确性负责
概念边界
判定标准是"批量产出且不投入把关",而不是"由模型参与生成"。用模型起草再由人核实、编辑并署名负责的内容不属于本词条;反过来,人工批量拼凑的无价值内容在机制上与它相同,只是速度慢一些。因此这条反模式的要害不是工具,而是产出规模与责任之间的脱节:谁为这条内容的准确性负责,如果没有人,那它就是本词条所指的东西。本条目是警示条目,不提供任何"如何更高效地批量生成"的做法。
什么时候考虑它
- 审查自有站点或信息流中是否已经混入这类内容
- 评估内容供应商或合作方交付物的真实投入
什么时候慎用
- 作为提升发布量或搜索排名的手段
- 把"有人事后粗略扫一眼"当作已经完成把关
取舍
修复的方向是把责任接回来:每条内容都有具名的负责人、可核实的来源与真实的编辑记录;产出速度因此下降,但被看见的内容才重新与投入挂钩。对平台而言,则是让批量、无来源的内容不再获得分发优势。
条件规则 · 编辑建议
相关词条
标记生成来源是必要的,但它本身不解决问题:一条被如实标记为 AI 生成的无价值内容,仍然是无价值内容。
无法追溯依据的内容不具备被核实的可能,读者只能选择相信或忽略。
读者无法逐条分辨,只能整体下调对该渠道的信任,连其中真正可靠的内容也一并受损。
可查看来源是把"相信"变成"可核实"的具体机制,也是这类内容最先缺失的东西。
来源与支持范围
该条目把 AI slop(又称 slop content 或 slop)定义为由生成式人工智能制作、被认为在投入、质量或意义上有所欠缺的数字内容,并记载 2024 年此类图像在社交平台上大量扩散的情况;本词条的定义据此转述,其中关于责任归属的判断属编辑意见。
检索日期:2026-09-16 · 快照待确认该政策把"规模化内容滥用"(scaled content abuse)定义为:为操纵搜索排名而非帮助用户这一主要目的生成大量页面;文中说明这一滥用行为通常表现为制造大量对用户几乎没有价值的非原创内容,"无论以何种方式创建",并把"使用生成式 AI 工具或类似工具批量生成页面而未为用户增加价值"列为其示例之一。本词条据此说明这一做法在搜索侧被如何界定,并据以支持"判定标准是规模与把关而非工具"的边界。
检索日期:2026-09-16 · 快照待确认定义参考以上来源;数字界面示例、选择建议、条件关系及配方由本样例编辑,尚未经用户研究验证。
类型扩展与实现说明
本词条是警示条目,不作为设计选用建议,也不提供批量生成的做法;插画为编辑示意,其中的标题与正文均为虚构的占位内容。审查自有渠道时,关注的应是"谁对这条内容负责",而不是"它是否由模型生成"。
{
  "harm": "以近乎为零的成本占据可见位置,把投入过编辑与核实的内容挤出视野,并让读者失去分辨的依据,最终下调对整个渠道的信任",
  "repair": "把责任接回来:每条内容有具名负责人、可核实来源与真实编辑记录;平台侧则取消批量无来源内容的分发优势,并让读者能按来源屏蔽。"
}
完整 Agent 条目 JSON
{
  "id": "ai-slop",
  "type": "anti",
  "name": {
    "zh": "AI 垃圾内容",
    "en": "AI Slop"
  },
  "aliases": [
    "Slop",
    "Slop Content",
    "AI 灌水",
    "生成式垃圾内容"
  ],
  "granularity": "experience",
  "intents": [
    "audit-choice",
    "disclose-ai-origin"
  ],
  "tags": [
    "反模式",
    "生成内容",
    "批量",
    "信息流",
    "搜索排名"
  ],
  "definition": "用生成模型批量产出、几乎不投入编辑与核实的内容:它的目的是占据信息流与搜索结果的位置,而不是对读者有用;单看一篇未必有明显错误,但成批出现时会把有价值的内容挤出可见范围。",
  "boundary": "判定标准是\"批量产出且不投入把关\",而不是\"由模型参与生成\"。用模型起草再由人核实、编辑并署名负责的内容不属于本词条;反过来,人工批量拼凑的无价值内容在机制上与它相同,只是速度慢一些。因此这条反模式的要害不是工具,而是产出规模与责任之间的脱节:谁为这条内容的准确性负责,如果没有人,那它就是本词条所指的东西。本条目是警示条目,不提供任何\"如何更高效地批量生成\"的做法。",
  "signature": [
    "同一模板的大量页面或帖子在短时间内出现",
    "内容回答的是检索词而不是读者的问题,正文绕开具体结论",
    "没有署名、没有来源,也没有人对准确性负责"
  ],
  "when": [
    "审查自有站点或信息流中是否已经混入这类内容",
    "评估内容供应商或合作方交付物的真实投入"
  ],
  "when_not": [
    "作为提升发布量或搜索排名的手段",
    "把\"有人事后粗略扫一眼\"当作已经完成把关"
  ],
  "tradeoff": "修复的方向是把责任接回来:每条内容都有具名的负责人、可核实的来源与真实的编辑记录;产出速度因此下降,但被看见的内容才重新与投入挂钩。对平台而言,则是让批量、无来源的内容不再获得分发优势。",
  "comparison": {
    "focus": "用批量产出占据可见位置而不承担把关责任",
    "mechanism": "模板化批量生成,不投入编辑、核实与署名",
    "cost": "把有价值的内容挤出可见范围,并侵蚀读者对整个渠道的信任"
  },
  "sources": [
    {
      "id": "aislop-wikipedia",
      "title": "Wikipedia · AI slop",
      "url": "https://en.wikipedia.org/wiki/Slop_(artificial_intelligence)",
      "claim": "该条目把 AI slop(又称 slop content 或 slop)定义为由生成式人工智能制作、被认为在投入、质量或意义上有所欠缺的数字内容,并记载 2024 年此类图像在社交平台上大量扩散的情况;本词条的定义据此转述,其中关于责任归属的判断属编辑意见。",
      "checkedAt": "2026-09-16",
      "archive": {
        "lookupUrl": "https://web.archive.org/web/20260916*/https://en.wikipedia.org/wiki/Slop_(artificial_intelligence)",
        "status": "pending",
        "checkedAt": "2026-09-16T17:42:19.185Z",
        "error": "status-request-failed",
        "jobId": "spn2-16e7d78c290ab3e9d07b01a0fffe3938e5cf6f1f"
      }
    },
    {
      "id": "aislop-google-spam",
      "title": "Google Search Central · Spam policies for Google web search",
      "url": "https://developers.google.com/search/docs/essentials/spam-policies",
      "claim": "该政策把\"规模化内容滥用\"(scaled content abuse)定义为:为操纵搜索排名而非帮助用户这一主要目的生成大量页面;文中说明这一滥用行为通常表现为制造大量对用户几乎没有价值的非原创内容,\"无论以何种方式创建\",并把\"使用生成式 AI 工具或类似工具批量生成页面而未为用户增加价值\"列为其示例之一。本词条据此说明这一做法在搜索侧被如何界定,并据以支持\"判定标准是规模与把关而非工具\"的边界。",
      "checkedAt": "2026-09-16",
      "archive": {
        "lookupUrl": "https://web.archive.org/web/20260916*/https://developers.google.com/search/docs/essentials/spam-policies",
        "status": "pending",
        "checkedAt": "2026-09-22T11:58:11.691Z",
        "error": "status-request-failed",
        "jobId": "spn2-75a0b4a06de3c28421b87101724178ad890ccec3"
      }
    }
  ],
  "relations": [
    {
      "target": "ai-label",
      "kind": "related",
      "condition": "内容确实由模型参与生成",
      "reason": "标记生成来源是必要的,但它本身不解决问题:一条被如实标记为 AI 生成的无价值内容,仍然是无价值内容。",
      "basis": "editorial"
    },
    {
      "target": "explainability",
      "kind": "conflicts_when",
      "condition": "内容给出结论却无法说明依据与来源",
      "reason": "无法追溯依据的内容不具备被核实的可能,读者只能选择相信或忽略。",
      "basis": "editorial"
    },
    {
      "target": "trust-calibration",
      "kind": "conflicts_when",
      "condition": "渠道中此类内容的比例上升",
      "reason": "读者无法逐条分辨,只能整体下调对该渠道的信任,连其中真正可靠的内容也一并受损。",
      "basis": "editorial"
    },
    {
      "target": "source-inspection",
      "kind": "related",
      "condition": "读者需要判断一条内容是否值得相信",
      "reason": "可查看来源是把\"相信\"变成\"可核实\"的具体机制,也是这类内容最先缺失的东西。",
      "basis": "editorial"
    }
  ],
  "rules": [
    {
      "when": "产品发布由模型参与生成的内容",
      "instruction": "为每一条指定一个对准确性负责的具名责任人,并保留可核实的来源;做不到时不要发布。",
      "strength": "must",
      "basis": "editorial"
    },
    {
      "when": "平台对用户产出的内容进行分发排序",
      "instruction": "不要让批量、无来源、无责任人的内容获得分发优势,并为读者提供按来源屏蔽的手段。",
      "strength": "recommend",
      "basis": "editorial"
    }
  ],
  "anti": {
    "harm": "以近乎为零的成本占据可见位置,把投入过编辑与核实的内容挤出视野,并让读者失去分辨的依据,最终下调对整个渠道的信任",
    "repair": "把责任接回来:每条内容有具名负责人、可核实来源与真实编辑记录;平台侧则取消批量无来源内容的分发优势,并让读者能按来源屏蔽。"
  },
  "demo": null,
  "version": "0.1.0",
  "editorialStatus": "drafted",
  "requirements": [],
  "demoCapabilities": [],
  "implementationNote": "本词条是警示条目,不作为设计选用建议,也不提供批量生成的做法;插画为编辑示意,其中的标题与正文均为虚构的占位内容。审查自有渠道时,关注的应是\"谁对这条内容负责\",而不是\"它是否由模型生成\"。",
  "image": {
    "src": "/images/ai-slop.webp",
    "alt": "一张示意图:一条虚构的信息流里排着许多结构完全相同的卡片,每张都有相似的占位标题条、相同长度的正文条和空白的作者位;其中一张有署名与来源标记的卡片被挤到边缘、几乎看不见。"
  },
  "searchTerms": [
    "anti-pattern",
    "generated content",
    "at scale",
    "feed",
    "search ranking"
  ]
}